開発者ツール · HTML エンティティ エスケープ
innerHTML を使用しない HTML エンティティのデコード: ルックアップ テーブル デコーダーの仕組み
· 仕組み
投稿ナビゲーション ToolAcre · 編集レビュー
html セキュリティ エンコード
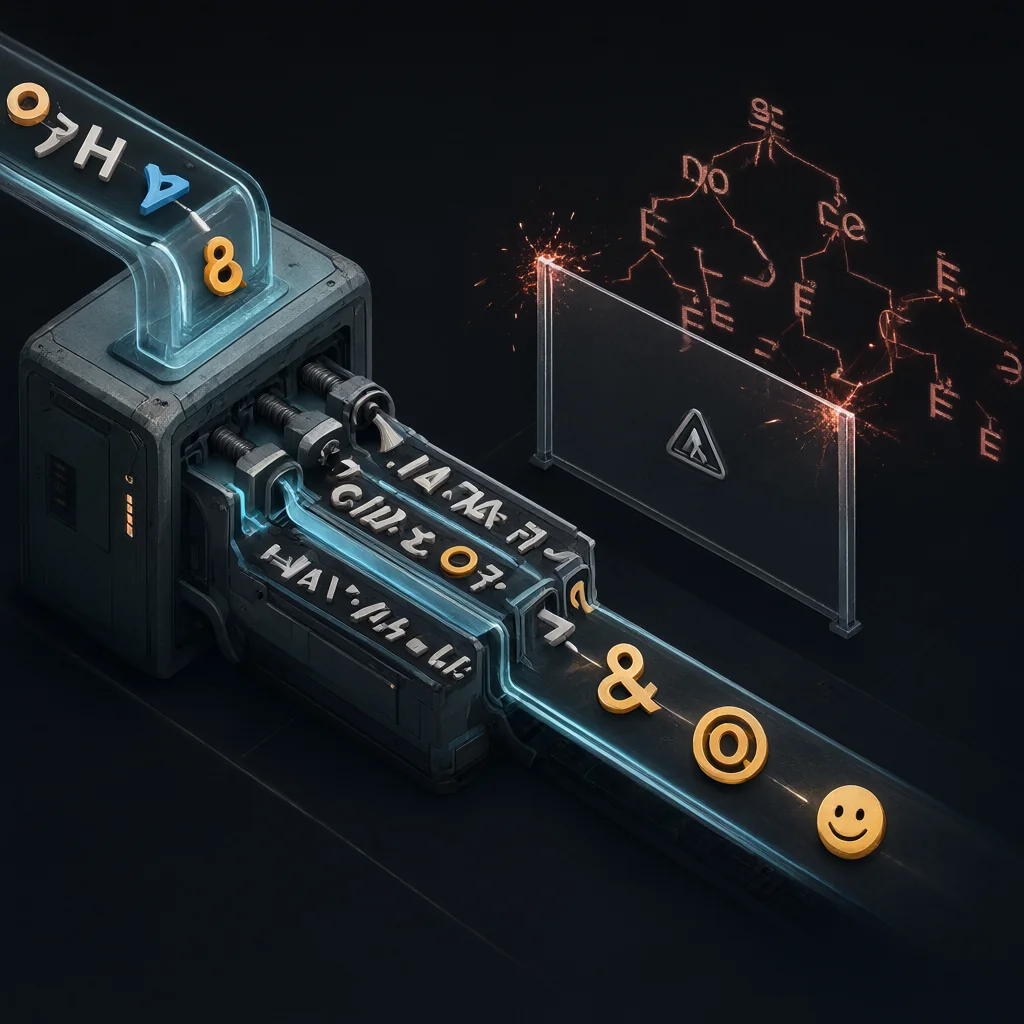
innerHTML に代入してエンティティをデコードする一般的な手法では、入力が HTML パーサーを介して実行されますが、これはまさに望ましくないことです。この投稿では、より安全なテーブルベースのアプローチと、それが名前付き、10 進数、および 16 進数の参照を処理する方法について説明します。
<img onerror> を実行したデコーダー — 「デコードするだけ」がスクリプト実行になる具体的なケース
使用方法 element.innerHTML デコード & しかし、またparses HTML. のような価値 <img src=x onerror=...> 要素とイベントハンドラの属性を作成できます。 ゴールが文字の参照を解読するだけであるとき、貼り付け続ける HTML- テキストをパースするのではなく、データを DOM ツリー.
innerHTML が文字列に対して実際に行うこと — エンティティの置換だけでなく、解析、要素の作成、イベント ハンドラー属性
innerHTML は HTML パーサーを呼び出します。タグはノードになり、属性はブラウザーの意味を取得し、その後の textContent の読み取りによって結果からマークアップが取り除かれます。リテラル入力として保持するつもりだった <strong> タグは、テキスト書式設定として消える可能性があります。分離された要素は一般的な安全性を保証するものではありません。コードは多くの場合、そのサブツリーを再挿入するか、結果の HTML を別の場所で使用します。信頼できない入力を表示する必要がある場合は、HTML のレンダリングを意図的に選択した場合にのみ、textContent を割り当ててサニタイズします。
ルックアップ テーブル アプローチ - &name;、&#NNN; の正規表現&#xHHH;、および名前からキャラクターへのマップ
ToolAcre’s デコダーは、フォームの参照を見つけるために境界正規表現を使用します &name;, { または {. 名前付き参照は、AMP、lt、gt、引用符、一般的なタイポグラフィーを含む実用的な明示的なテーブルで見上げられます。 見かけのではなく、未知名の名前が書かれている。 このアプローチは要素を生成せず、要素を呼び出さない HTML パーサ; 単に認識されたサブストリングを文字列に置き換えます。 テーブルは、すべてのサブセットではなく、意図的にサブセットです HTML 文字参照の名前.
数値参照の処理 - 10 進数および 16 進数のコード ポイントを解析し、アストラル文字を含む文字列に変換します。
数値参照の場合、&# の後の 10 進数または &#x の後の 16 進数を解析し、String.fromCodePoint を使用して数値のコード ポイントを文字に変換します。 0x1F600 などのアストラル値は、2 つの独立した印刷可能な文字ではなく、絵文字を生成します。この実装では、ブラウザーと同様に、過去の Windows-1252 制御範囲値もマップされます。ゼロ、サロゲート コード ポイント、および U+10FFFF を超える値は置換文字になります。この明示的なエラー処理により、無効な数値によるデコーダのクラッシュが防止されます。
作業例: ミックスする文字列を解読する &, © と 😀 — 各マッチはテーブルや数字から解決しました
文字入力をデコードする &, © と 😀: 名前付きテーブルから&、小数までの最初の参照マップ 169 とりあえず、ヘックス1F600がなる 生を含まて下さい <img onerror="alert(1)"> それら以外にも デコダーは、タグの見栄えのシーケンスを通常の文字列文字として返します。それはイメージを作成したり、イベントを実行しません。 結果を実際のページにしてから、デコードされた文字列をとって、それを内部HTMLに返すのではなく、安全なテキストシンクを使用します.
テーブルアプローチではできないこと — 意図的に実装されない限り、従来のセミコロンのない参照とパーサーのエラー回復の癖
ルックアップ アプローチでは、HTML パーサーのセミコロンのない従来のリカバリ ルールを意図的に再現しません。セミコロンのない © はそのまま残される場合があります。修正された名前付きテーブルでは、2,000 を超える HTML5 名前付き参照の多くも省略されています。これらの制限は、予測可能な小さなデコーダにとっては正直なトレードオフです。明示的に終了した参照のみを受け入れることで、アンパサンドを含む任意の散文をマークアップとして扱うことを回避できます。ブラウザーの完全な互換性が不可欠な場合は、ツールの文書化されたサポート名を確認してください。
これでカバーされないこと — レンダリングする予定の HTML のサニタイズ (別の問題)
参照のデコードでは、表示用の HTML がサニタイズされません。デコードされたテキストに <script> シーケンスが含まれている場合、後でアプリケーションの別の部分がそれをマークアップとして挿入した場合に危険が残ります。 HTML 属性、JavaScript 文字列、URL などのコンテキストには、それぞれ独自の出力エンコーディングとポリシーが必要です。 ToolAcre はテキストを返します。将来的に危険なシンクを安全にすることはできません。
要点: 入力をデータとして扱う — HTML エンティティ エスケープが HTML パーサーではなくルックアップ テーブルを使用してデコードし、入力がテキストのままになる方法
入力をデータとして扱います。 HTML エンティティ エスケープ機能は、innerHTML トリックではなく、テーブルとコードポイントの算術演算を使用してデコードするため、マークアップに見えるペイロードはツール内で不活性な文字のままになります。 3 つのリファレンスを試してから、デコードされたテキストと、それを次にどのように使用する予定かを調べてください。HTML として再解析すると、安全境界が失われます。