Alat pengembang · HTML pelarian entitas
Mendekode entitas HTML tanpa innerHTML: cara kerja dekoder tabel pencarian
· Cara kerjanya
Diterbitkan oleh ToolAcre · Ulasan Editorial
html keamanan pengkodean
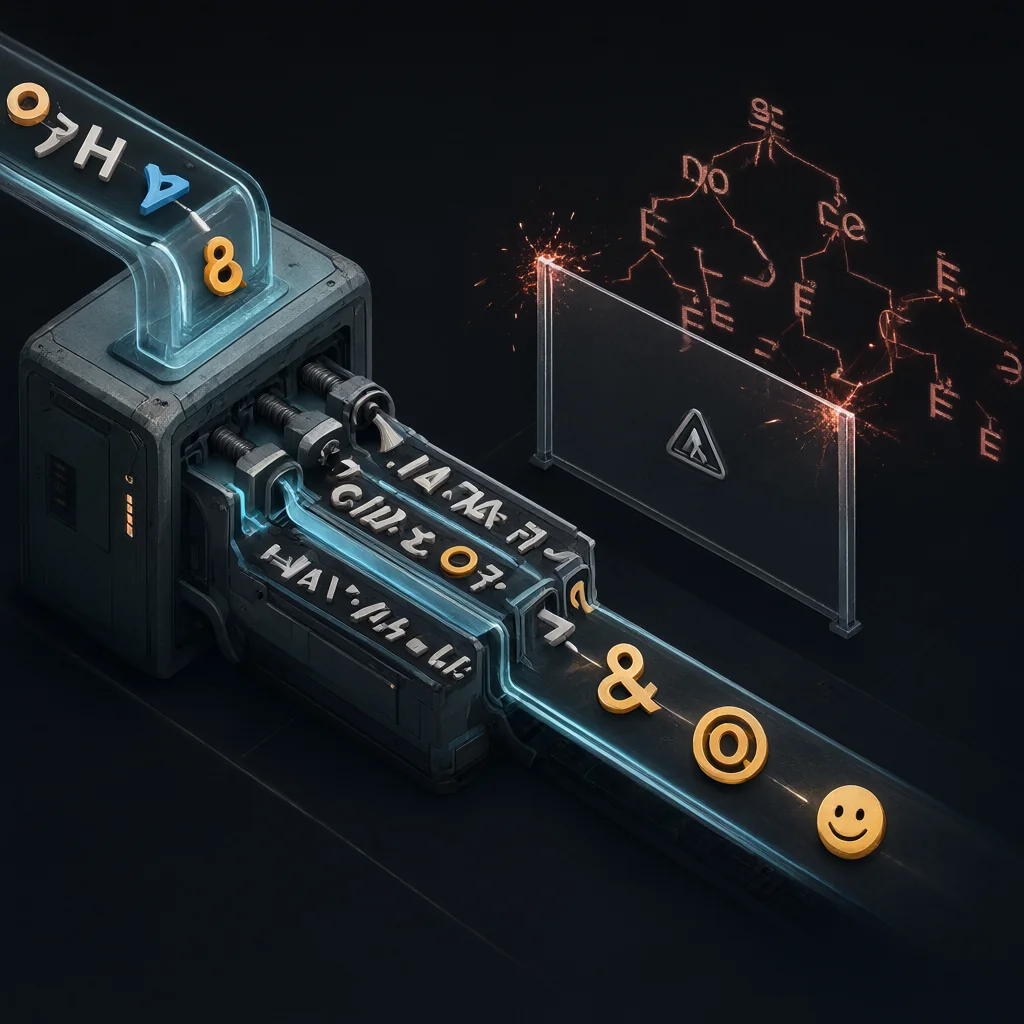
Trik populer dalam mendekode entitas dengan menugaskan innerHTML menjalankan masukan Anda melalui parser HTML, yang sebenarnya tidak Anda inginkan. Posting ini menjelaskan pendekatan berbasis tabel yang lebih aman dan cara menangani referensi bernama, desimal, dan hex.
Dekoder yang mengeksekusi <img onerror> — kasus nyata di mana 'decode saja' menjadi eksekusi skrip
Menggunakan element.innerHTML decode & tetapi juga parses HTMLSebuah nilai seperti <img src=x onerror=...> dapat membuat atribut elemen dan event-handler. Ketika tujuan hanya untuk memecahkan kode referensi karakter, terus menempel HTML-seperti teks sebagai data daripada parsing ke DOM pohon.
Apa yang sebenarnya dilakukan innerHTML dengan string — penguraian, pembuatan elemen, dan atribut pengendali peristiwa, bukan hanya penggantian entitas
innerHTML memanggil parser HTML: tag menjadi node, atribut memperoleh makna browser, dan pembacaan textContent yang lebih baru menghapus markup dari hasilnya. Tag <strong> yang ingin Anda pertahankan sebagai masukan literal dapat hilang seiring pemformatan teks. Elemen yang terlepas bukanlah jaminan keamanan umum; kode sering kali memasukkan kembali subpohon tersebut atau menggunakan HTML yang dihasilkan di tempat lain. Jika Anda perlu menampilkan masukan yang tidak tepercaya, tetapkan konten teks dan bersihkan hanya jika Anda dengan sengaja memilih untuk merender HTML.
Pendekatan tabel pencarian — ekspresi reguler untuk &name;, &#NNN; dan &#xHHH;, dan peta dari nama hingga karakter
ToolAcredecoder menggunakan ekspresi reguler yang terbatas untuk menemukan referensi dari bentuk &name;, { atau {Referensi bernama dicari dalam tabel eksplisit praktis, termasuk amp, lt, gt, kutipan dan tipografi umum. Nama yang tidak diketahui adalah yang tertulis daripada menebak. Pendekatan ini tidak menciptakan elemen dan panggilan tidak ada HTML parser; itu hanya menggantikan substring yang dikenali dalam string. Tabel sengaja subset, tidak semua HTML bernama karakter referensi.
Menangani referensi numerik — mengurai titik kode desimal dan heksadesimal dan mengubahnya menjadi string, termasuk karakter astral
Untuk referensi numerik, parsing desimal setelah &# atau heksadesimal setelah &#x, lalu ubah titik kode numerik menjadi karakter dengan String.fromCodePoint. Nilai astral seperti 0x1F600 menghasilkan satu emoji, bukan dua karakter independen yang dapat dicetak. Implementasinya juga memetakan nilai rentang kendali Windows-1252 yang bersejarah seperti yang dilakukan browser; nol, titik kode pengganti dan nilai di atas U+10FFFF menjadi karakter pengganti. Penanganan kesalahan eksplisit tersebut mencegah nomor yang tidak valid merusak dekoder.
Contoh yang berhasil: menguraikan string yang bercampur &, © dan 😀 - setiap kecocokan diselesaikan dari tabel atau nomor
Decode masukan literal &, © dan 😀: peta referensi pertama melalui tabel bernama untuk &, desimal 169 menjadi ©, dan hex 1F600 menjadi 😀Termasuk mentah <img onerror="alert(1)"> di samping mereka. Decoder mengembalikan urutan pencarian tag sebagai karakter string biasa; ini tidak membuat gambar atau menjalankan suatu kejadian. Ketika meletakkan hasil ke halaman nyata kemudian, gunakan muara teks yang aman daripada mengambil string yang didekode dan memasukkannya kembali ke innerHTML.
Apa yang tidak akan dilakukan oleh pendekatan tabel - referensi lama tanpa titik koma dan kebiasaan pemulihan kesalahan parser, kecuali jika diterapkan dengan sengaja
Pendekatan pencarian sengaja tidak mereproduksi aturan pemulihan tanpa titik koma lama dari parser HTML. © tanpa titik koma mungkin tetap tidak tersentuh. Tabel bernama tetap juga menghilangkan lebih dari dua ribu referensi bernama HTML5. Keterbatasan tersebut merupakan trade-off yang jujur untuk decoder kecil yang dapat diprediksi; hanya menerima referensi yang diakhiri secara eksplisit menghindari memperlakukan prosa sewenang-wenang yang mengandung ampersand sebagai markup. Periksa nama alat yang didukung dan didokumentasikan jika kompatibilitas penuh browser sangat penting.
Hal yang tidak tercakup dalam hal ini — membersihkan HTML yang ingin Anda render, yang merupakan masalah lain
Referensi decoding tidak membersihkan HTML untuk ditampilkan. Jika teks yang didekode berisi urutan <script>, tetap berbahaya jika bagian lain dari aplikasi kemudian menyisipkannya sebagai markup. Konteks seperti atribut HTML, string JavaScript, dan URL masing-masing memerlukan pengkodean dan kebijakan keluarannya sendiri. ToolAcre mengembalikan teks; hal ini tidak dapat membuat masa depan yang tidak aman tenggelam menjadi aman.
Kesimpulan: perlakukan masukan sebagai data — cara escaper entitas HTML mendekode dengan tabel pencarian, bukan parser HTML, sehingga masukan Anda tetap berupa teks
Perlakukan masukan sebagai data. HTML entitas escaper mendekodekan dengan tabel dan aritmatika titik kode, bukan trik innerHTML, sehingga payload yang tampak markup tetap berupa karakter inert di dalam alat. Cobalah ketiga referensi tersebut, lalu periksa teks yang didekodekan dan bagaimana Anda berencana menggunakannya selanjutnya: batas keamanan akan hilang jika Anda menguraikannya kembali menjadi HTML.